SRv6. Часть 3. Тестирование отказов.
КПЗ “мёртвый свич”
Тут часть 1: https://likeabus.ru/manualstory/2026/09/02/srv6-frr-lab.html
Тут часть 2: https://likeabus.ru/manualstory/2026/09/06/srv6-frr-lab-te.html
Тут часть 2.5: https://likeabus.ru/manualstory/2026/09/13/srv6-frr-lab-ctrl.html
Мы до этого уже сделали полноценную лабу с SRv6, контроллером, который по BGP-LS собирает инфу и управляет трафиком на хостах. Сейчас же захотелось пойти дальше и проверить то, как вся эта наша возня будет реагировать на отказы.
То есть в этой части, будем ломать. Потом чинить. Собирать данные и делать вывода.
Но, перед тем как всё сломать, нам нужно добавить кое-чего. Давайте по очереди.
Во-первых нам нужна нагрузка
Тут я решил идти проверенным путём и просто пускать трафик используя iperf. Почему его, а не TRex к примеру? Да всё просто, у меня в любом случае пакеты пойдут через ядро, т.к. это всё контейнеры в моём WSL и нормального userspace никак не получу, поэтому прироста по полосе не сделать, а вот проблем с ним будет точно много.
Для iperf есть удобный контейнер, nicolaka/netshoot, хорошая сборка, там куча всякого добра полезного для сетевиков лежит. Мы её кстати и у себя в проде используем для подобных задач, где надо что-то с куба потестить.
Короче вот этот образ взял, поставил за CE и на нём разместил префиксы, которые уйдут с CE по BGP в PE.
Вот, что-то типа такого:
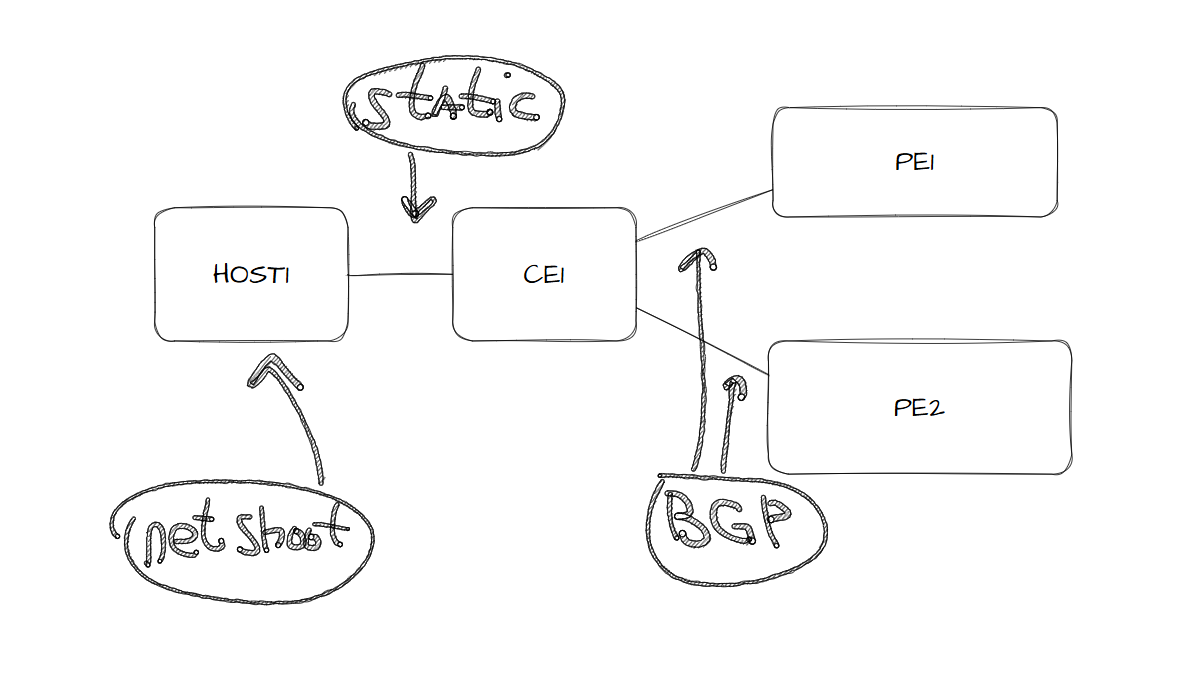
Ну и с другой стороны тоже самое. В итоге у нас уже может пройти трафик напрямую от H1 до H2. Го проверим:
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ sudo docker exec -it clab-srv6-lab2-h2 iperf3 -s -i 0.1 &
[3] 3332309

likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ sudo docker exec -it clab-srv6-lab2-h1 iperf3 -c 10.2.0.2 -u -b 100M -t 60 -i 0.1
Connecting to host 10.2.0.2, port 5201
[  5] local 10.1.0.2 port 42323 connected to 10.2.0.2 port 5201
[ ID] Interval           Transfer     Bitrate         Total Datagrams
[  5]   0.00-0.10   sec  1.19 MBytes  99.9 Mbits/sec  864
[  5]   0.10-0.20   sec  1.19 MBytes   100 Mbits/sec  864
[  5]   0.20-0.30   sec  1.19 MBytes   100 Mbits/sec  863
[  5]   0.30-0.40   sec  1.19 MBytes  99.9 Mbits/sec  863
[  5]   0.40-0.50   sec  1.19 MBytes   100 Mbits/sec  863
[  5]   0.50-0.60   sec  1.19 MBytes   100 Mbits/sec  864
[  5]   0.60-0.70   sec  1.19 MBytes   100 Mbits/sec  863

...
Кайф, трафик льётся как водичка, значит тут всё!
Во-вторых нужен мониторинг
Не будем же мы бегать и руками каждый счетчик собирать, а потом сравнивать. Не ну можно конечно обмазаться какими-то скриптами, но мы парни взрослые, делаем нормально. Короче добавляем ещё парочку контейнеров:
- ВикторияМетрикс
- Графана
Нормальная, “индастри реди” схема!
Так, ну скачали, добавили в скрипт по запуску, остаётся вопрос как метрики то собирать?? Можно конечно налепить тут всяких SNMP, телеметрий и прочий херни, но зачем, когда у нас это всё в лабе?
Короче, взял и начал собирать метрики напрямую с интерфейсов containerlab. Вот так:
sudo cat /proc/$(sudo docker inspect -f '' clab-srv6-lab2-p1)/net/dev
Размазываем это всё на весь парк и получаем сбор метрик со всех наших интерфейсов и отрисовку в графане! Конечно же я не делал тут все эти штуки сам, у меня есть покорный Клод (на всякий напишу с большой).
В итоге вышло вот так:
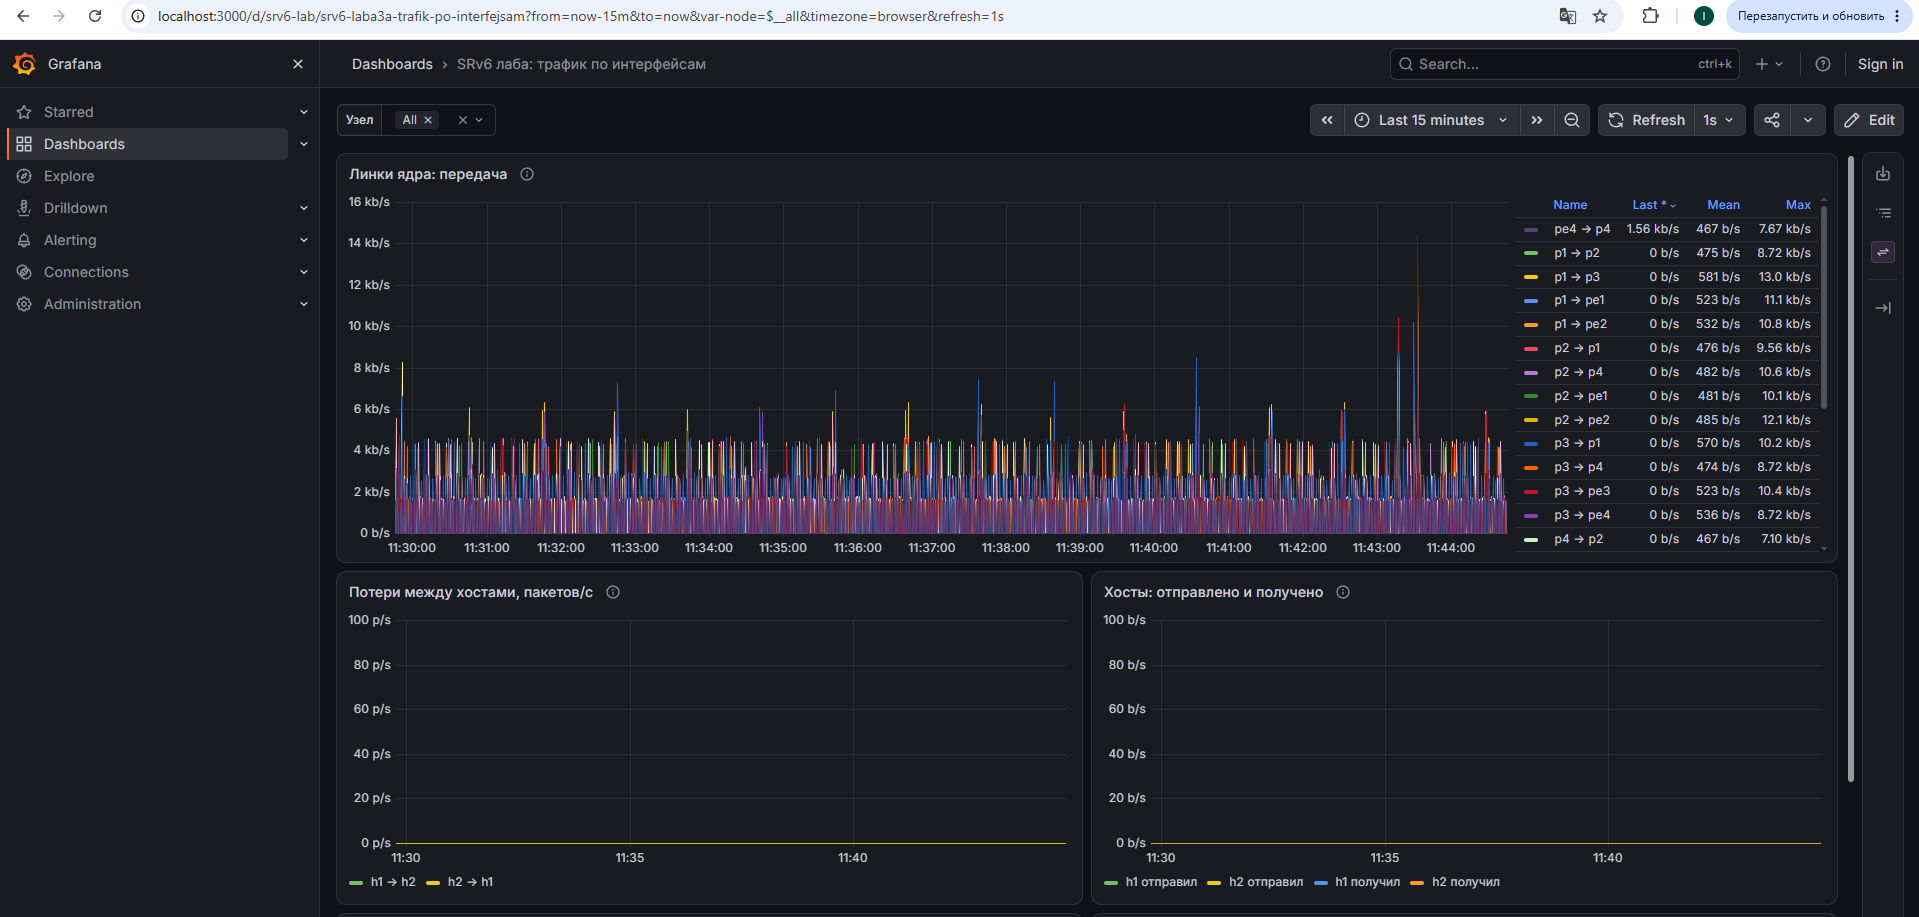
Обратите внимание, вот этот трафик, который на графике - это ISIS пакетики. Я когда впервые запустил, там вообще был флуд под 1Mbps, выключил padding и стало сильно лучше.
А если запустить трафик, то вот так:
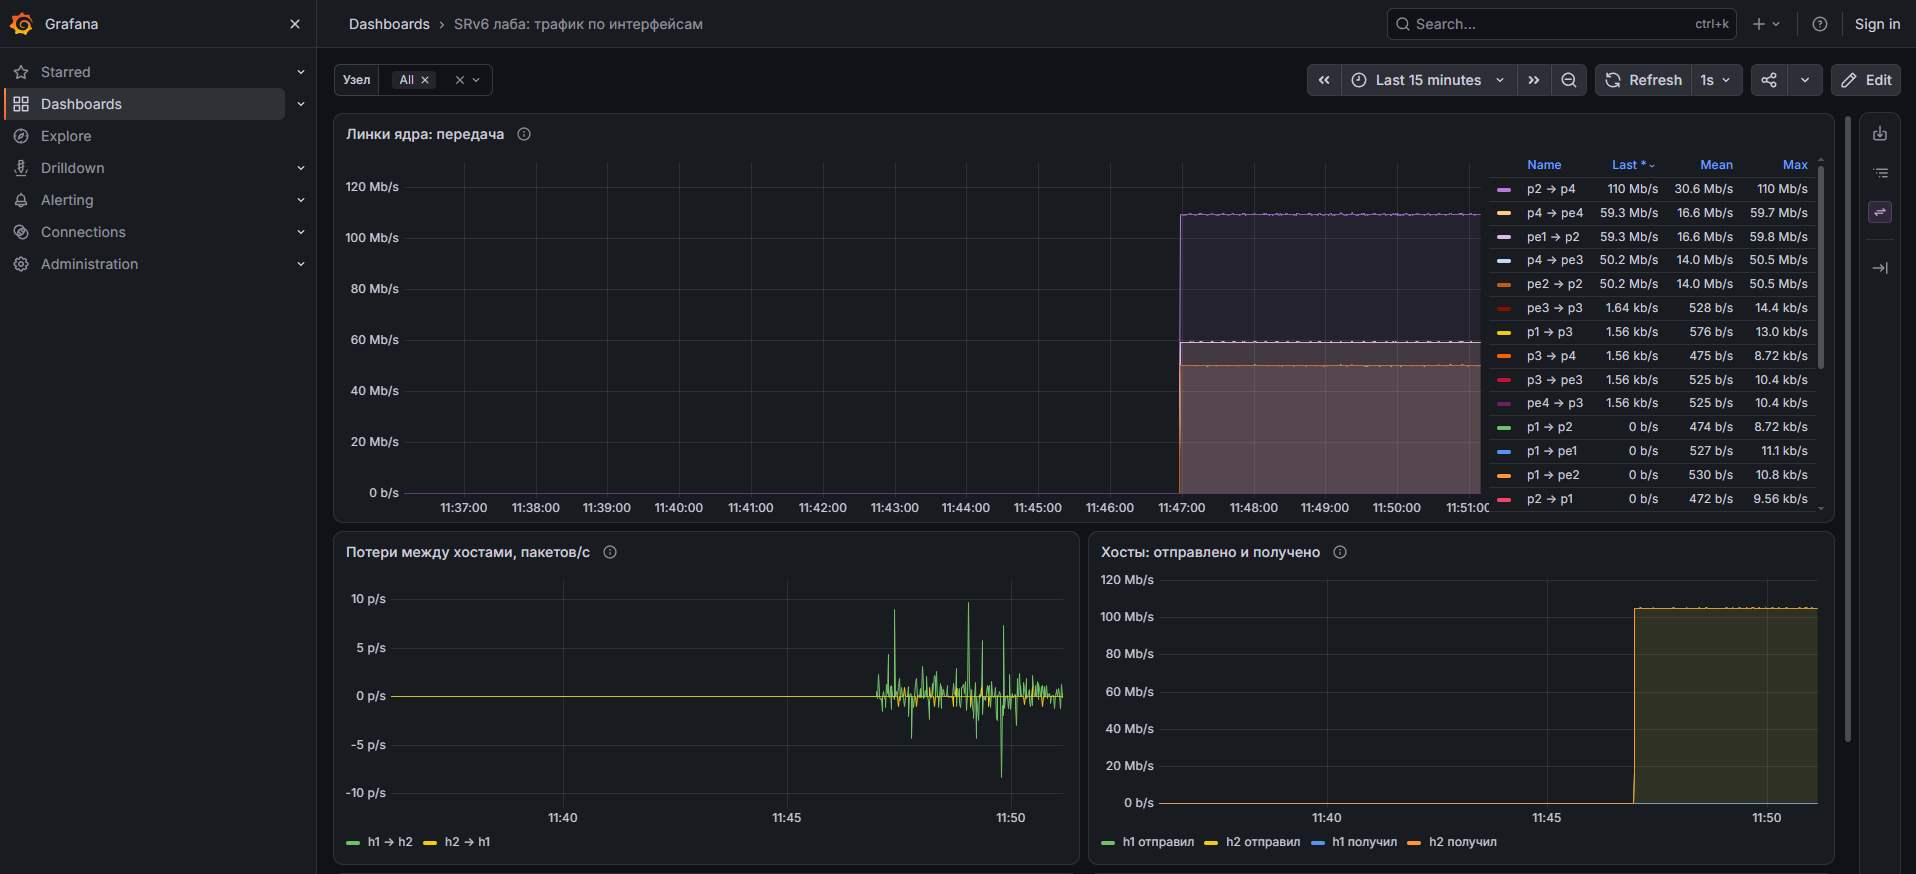
Я пускаю не больше 100Mpbs, просто потому что это ведь мой домашний комп, и там внутри него сильнее шурудить не хочется, да и для тестов отказов достаточно будет этого.
В-третьих удобство
В общем, я конечно же не собираюсь сам запускать трафик, ходить и в консоли скрипты эти жмякать, у меня есть контроллер, пусть там и будет эта кнопка. Мной сказано - Клодом сделано.
Вот такая кнопка появилась в менюшке:
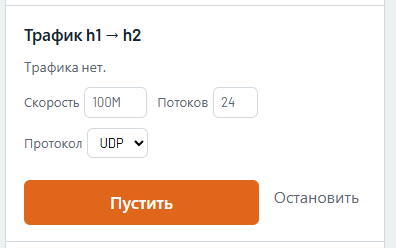
Суть проста, она запускает iperf с клиента и сервера, с указанными в ней параметрами. И плюс показывает текущее состояние.
Так, ну трафик пустили - ок, но для нормального теста отказа, нужно чтобы он гарантированно прошёл по какому-то из плечей.
Для этого нужно добавить ещё одну кнопку управления. Делать ничего сложного она не будет, просто меняет метрики ISIS на P узлах, таким
образом они будут либо участвовать в потоке трафика, либо выбывать, при этом переключение на них произойдёт автоматически:
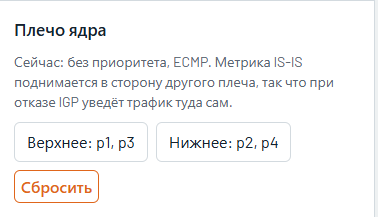
Получается такая картина: жмёшь на кнопку трафика и выбираешь по какому пути он должен пройти - получаешь гарантированный трафик флоу с полосой 100 Mbps.
Когда вот это всё сделал, обнаружил такую проблемку, что у меня не равномерно трафик балансируется на PE-узлах, т.е. не хватало видимо энтропии ему. Я не стал как-то сильно усложнять всю схему и что-то там изменять в плане нагрузки, просто добавил flow label и включил его на всех нодах.
net.ipv4.fib_multipath_hash_policy: 1
net.ipv6.seg6_flowlabel: 1
После этого всё сразу пошло как надо и пакеты размазались по всей сети.
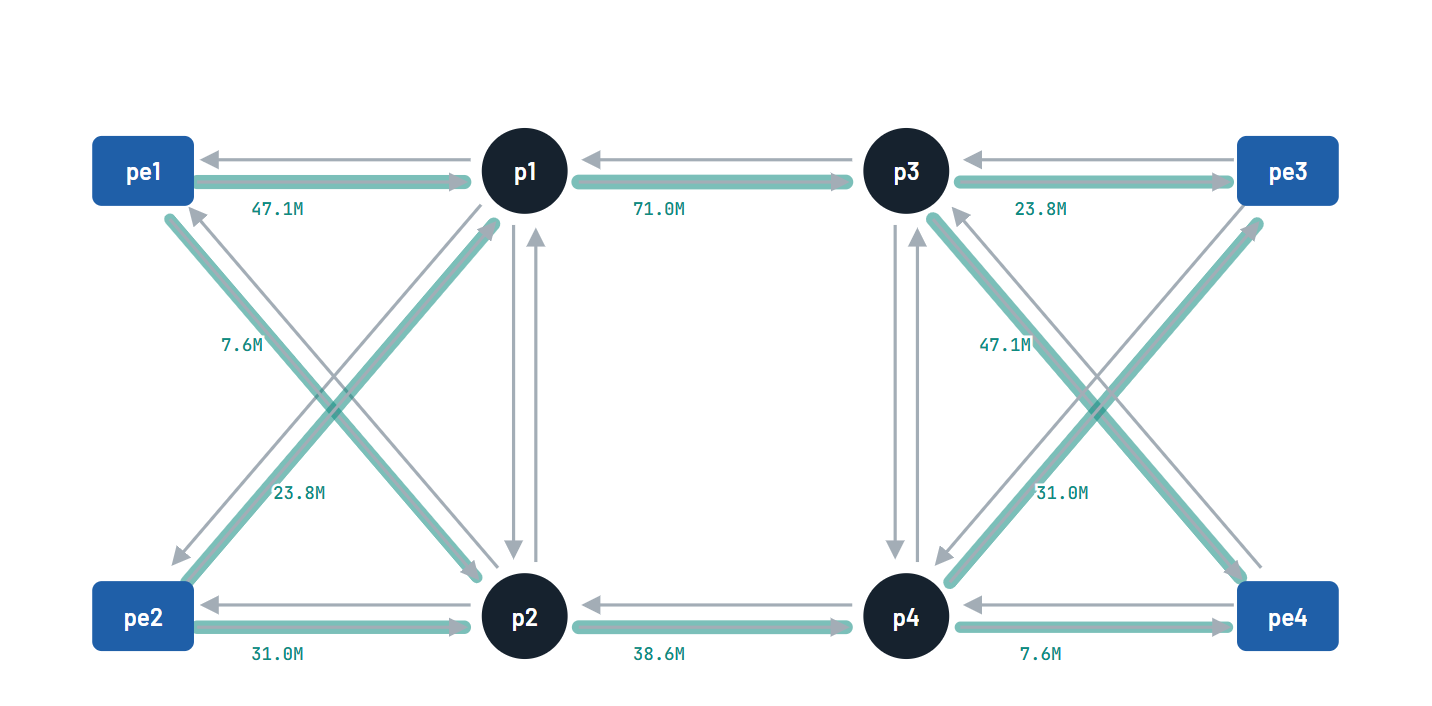
А, ну ещё я попросил клода добавить текущий bps линка прям в контроллер, чтобы быстро видеть есть там трафик или нет, без переключения в окно с графаной.
В итоге получилось вот так:
Ещё один, немаловажный пункт удобства - это дизайн. Как вы уже заметили, контроллер превратился в нечто большее, а не только штуку для выбора маршрутов. Поэтому я подумал, подраскинул мозгами так сказать, покумекал… В итоге решил, что теперь он будет называться БУДКА. Ну типа сигнальная будка. Плюс ему нужен какой-то символ - очевидно тоже будка. И конечно же тёмная тема. Куда ж без неё.
Итог:
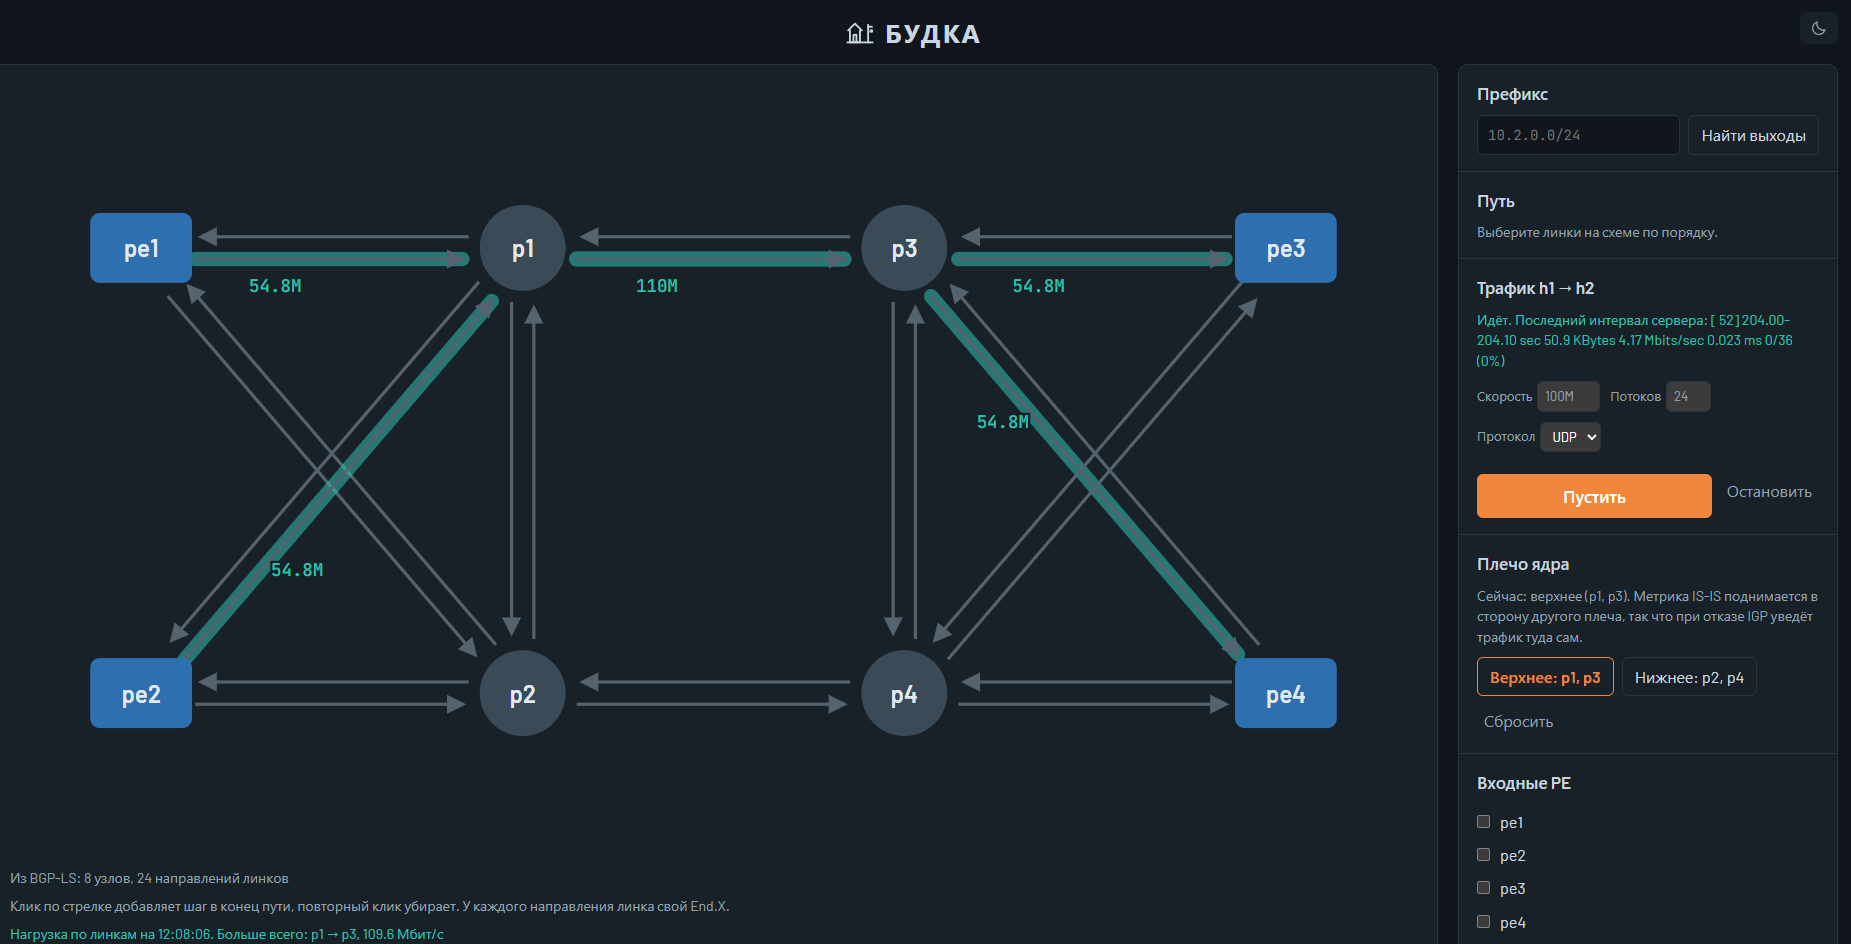
Темы переключаются, трафик запускается, всё отрисовывается, можно выбрать приоритет плеча или вообще задать какой-то ТЕ маршрут.
Единственное, что я не стал уже как-то обходить и решать, так это то, что если мы задаём ТЕ, то т.к. это реализуется статикой и используются End.X функции, то при явном выпадении такого интерфейса, у нас будет гарантированный drop, а у меня на схеме их не так много, чтобы построить наглядную схему с автоматическим переключением под нагрузкой в условиях TE. Поэтому просто дальше я не буду его использовать, но он работает и в целом можно добавить ещё штук 8 P узлов в ядро и станет тогда очень просто и наглядно делать тесты прям с учетом какого-то конкретного ТЕ маршрута.
Кажется можно ломать?
Ну собственно да, мы всё сделали, что хотели предварительно. Можно всё это теперь сломать и заново починить.
Единственная проблема, это то, что у меня всё-таки это лаба, причем не просто лаба, а лаба в контейнере, сам который живёт в другом контейнере. Жаба гадюку, ага. Не получается тут как-то честно выключать ноду, т.к. если containerlab теряет узел, то после его старта, не может привязать интерфейс корректно. Я что-то там пытался это починить, но безрезультатно. Решил, что буду просто делать следующие тесты:
- выключать отдельные линки
- гасить все линки узла разом, как при потере питания
- дропать трафик через tc, чтобы линк оставался в up, но вся контролька ломалась
Тут конечно же возникла идея добавить это тоже в Будку, но не стал, т.к. кажется суть её всё-таки в управлении трафиком, а не в том, чтобы его ломать :) Поэтому просто попросил Клода написать мне простой скрипт, который будет делать какие-то действия, ждать N время и делать следующие. Просто в общем повторить действия инженера, который тестирует отказы. А потом уже мы соберём это всё, посмотрим в графану и будем делать выводы.
Скрипт получился вот такой:
# Сценарии:
#   uplink     один аплинк PE в ядро гаснет
#   downlink   линк PE в сторону CE гаснет, проверяет dual-homing
#   both       оба аплинка PE сразу: PE остаётся без ядра
#   box        вся коробка P: все линки гаснут, как при потере питания
#   pe         весь PE целиком
#   hang       узел P завис: линки подняты, carrier есть, пакеты пропадают

scenario() {
  local title="$1" break_cmd="$2" fix_cmd="$3"
  n0=$(mark)                       # отметка в логе сервера iperf
  eval "$break_cmd"; sleep "$BREAK_WAIT"
  echo -n "    потери на отказе:   "; losses "$n0"
  n0=$(mark)
  eval "$fix_cmd";   sleep "$FIX_WAIT"
  echo -n "    потери на возврате: "; losses "$n0"
}
Сначала ломает раз, потом два, потом три, в конце всё это сгружает в файлик тхт.
Ок. Делаем.
Сначала проверил, что трафик идёт по нижнему плечу:
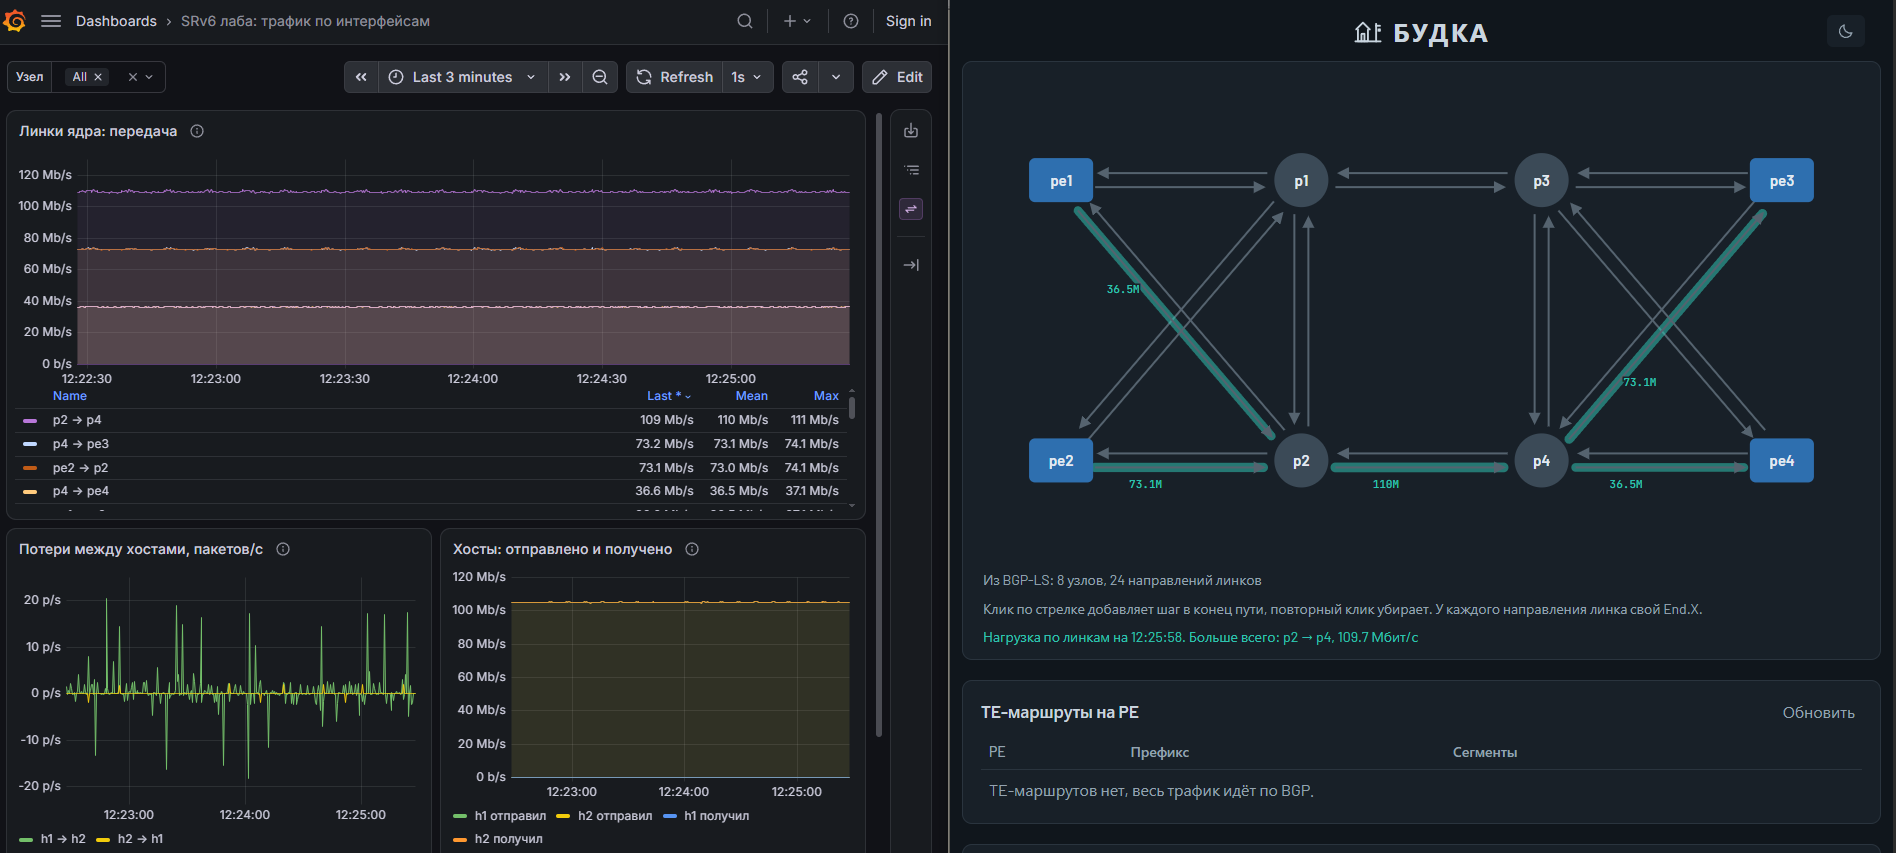
Всё ровно, пакеты идут по нижнему пути. Можно включать наш скрипт.
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ bash te/failover.sh
Узлы под тестом: pe1 (аплинки: eth1 eth2, к CE: eth3), p2 (всё: eth1 eth2 eth3 eth4 )
Путь до отказа:
    ce1>pe2 26.3 Мбит/с
    ce1>pe1 78.8 Мбит/с
    h1>ce1 105.0 Мбит/с
    p2>p4 109.6 Мбит/с
    p4>pe4 82.2 Мбит/с
    p4>pe3 27.4 Мбит/с
    pe1>p2 82.2 Мбит/с
    pe2>p2 27.4 Мбит/с
    pe3>ce2 26.3 Мбит/с
    pe4>ce2 78.8 Мбит/с
    ce2>h2 105.1 Мбит/с

=== Отказ аплинка: pe1 теряет линк eth1 в ядро
--- ломаю в 13:00:30.428
    потери на отказе:  без потерь
--- чиню в  13:01:10.572
    потери на возврате: без потерь

=== Отказ даунлинка: pe1 теряет линк eth3 к CE
--- ломаю в 13:01:23.144
    потери на отказе:  3 пакетов, связи не было 100 мс
--- чиню в  13:02:01.320
    потери на возврате: без потерь

=== Отказ обоих аплинков: pe1 остаётся без ядра
--- ломаю в 13:02:16.598
    потери на отказе:  без потерь
--- чиню в  13:02:51.826
    потери на возврате: без потерь

=== Отказ коробки: на p2 гаснут все линки
--- ломаю в 13:03:07.190
    потери на отказе:  467982 пакетов, связи не было 200 мс
--- чиню в  13:03:47.513
    потери на возврате: без потерь

=== Отказ PE целиком: на pe1 гаснут все линки
--- ломаю в 13:03:58.936
    потери на отказе:  366 пакетов, связи не было 100 мс
--- чиню в  13:04:39.183
    потери на возврате: 83598 пакетов, связи не было 100 мс

=== Зависание: линки p2 подняты, но пакеты пропадают
--- ломаю в 13:04:54.565
    потери на отказе:  254741 пакетов, связи не было 200 мс
--- чиню в  13:05:34.861
    потери на возврате: без потерь

likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$
А вот что рисует нам наша графана:
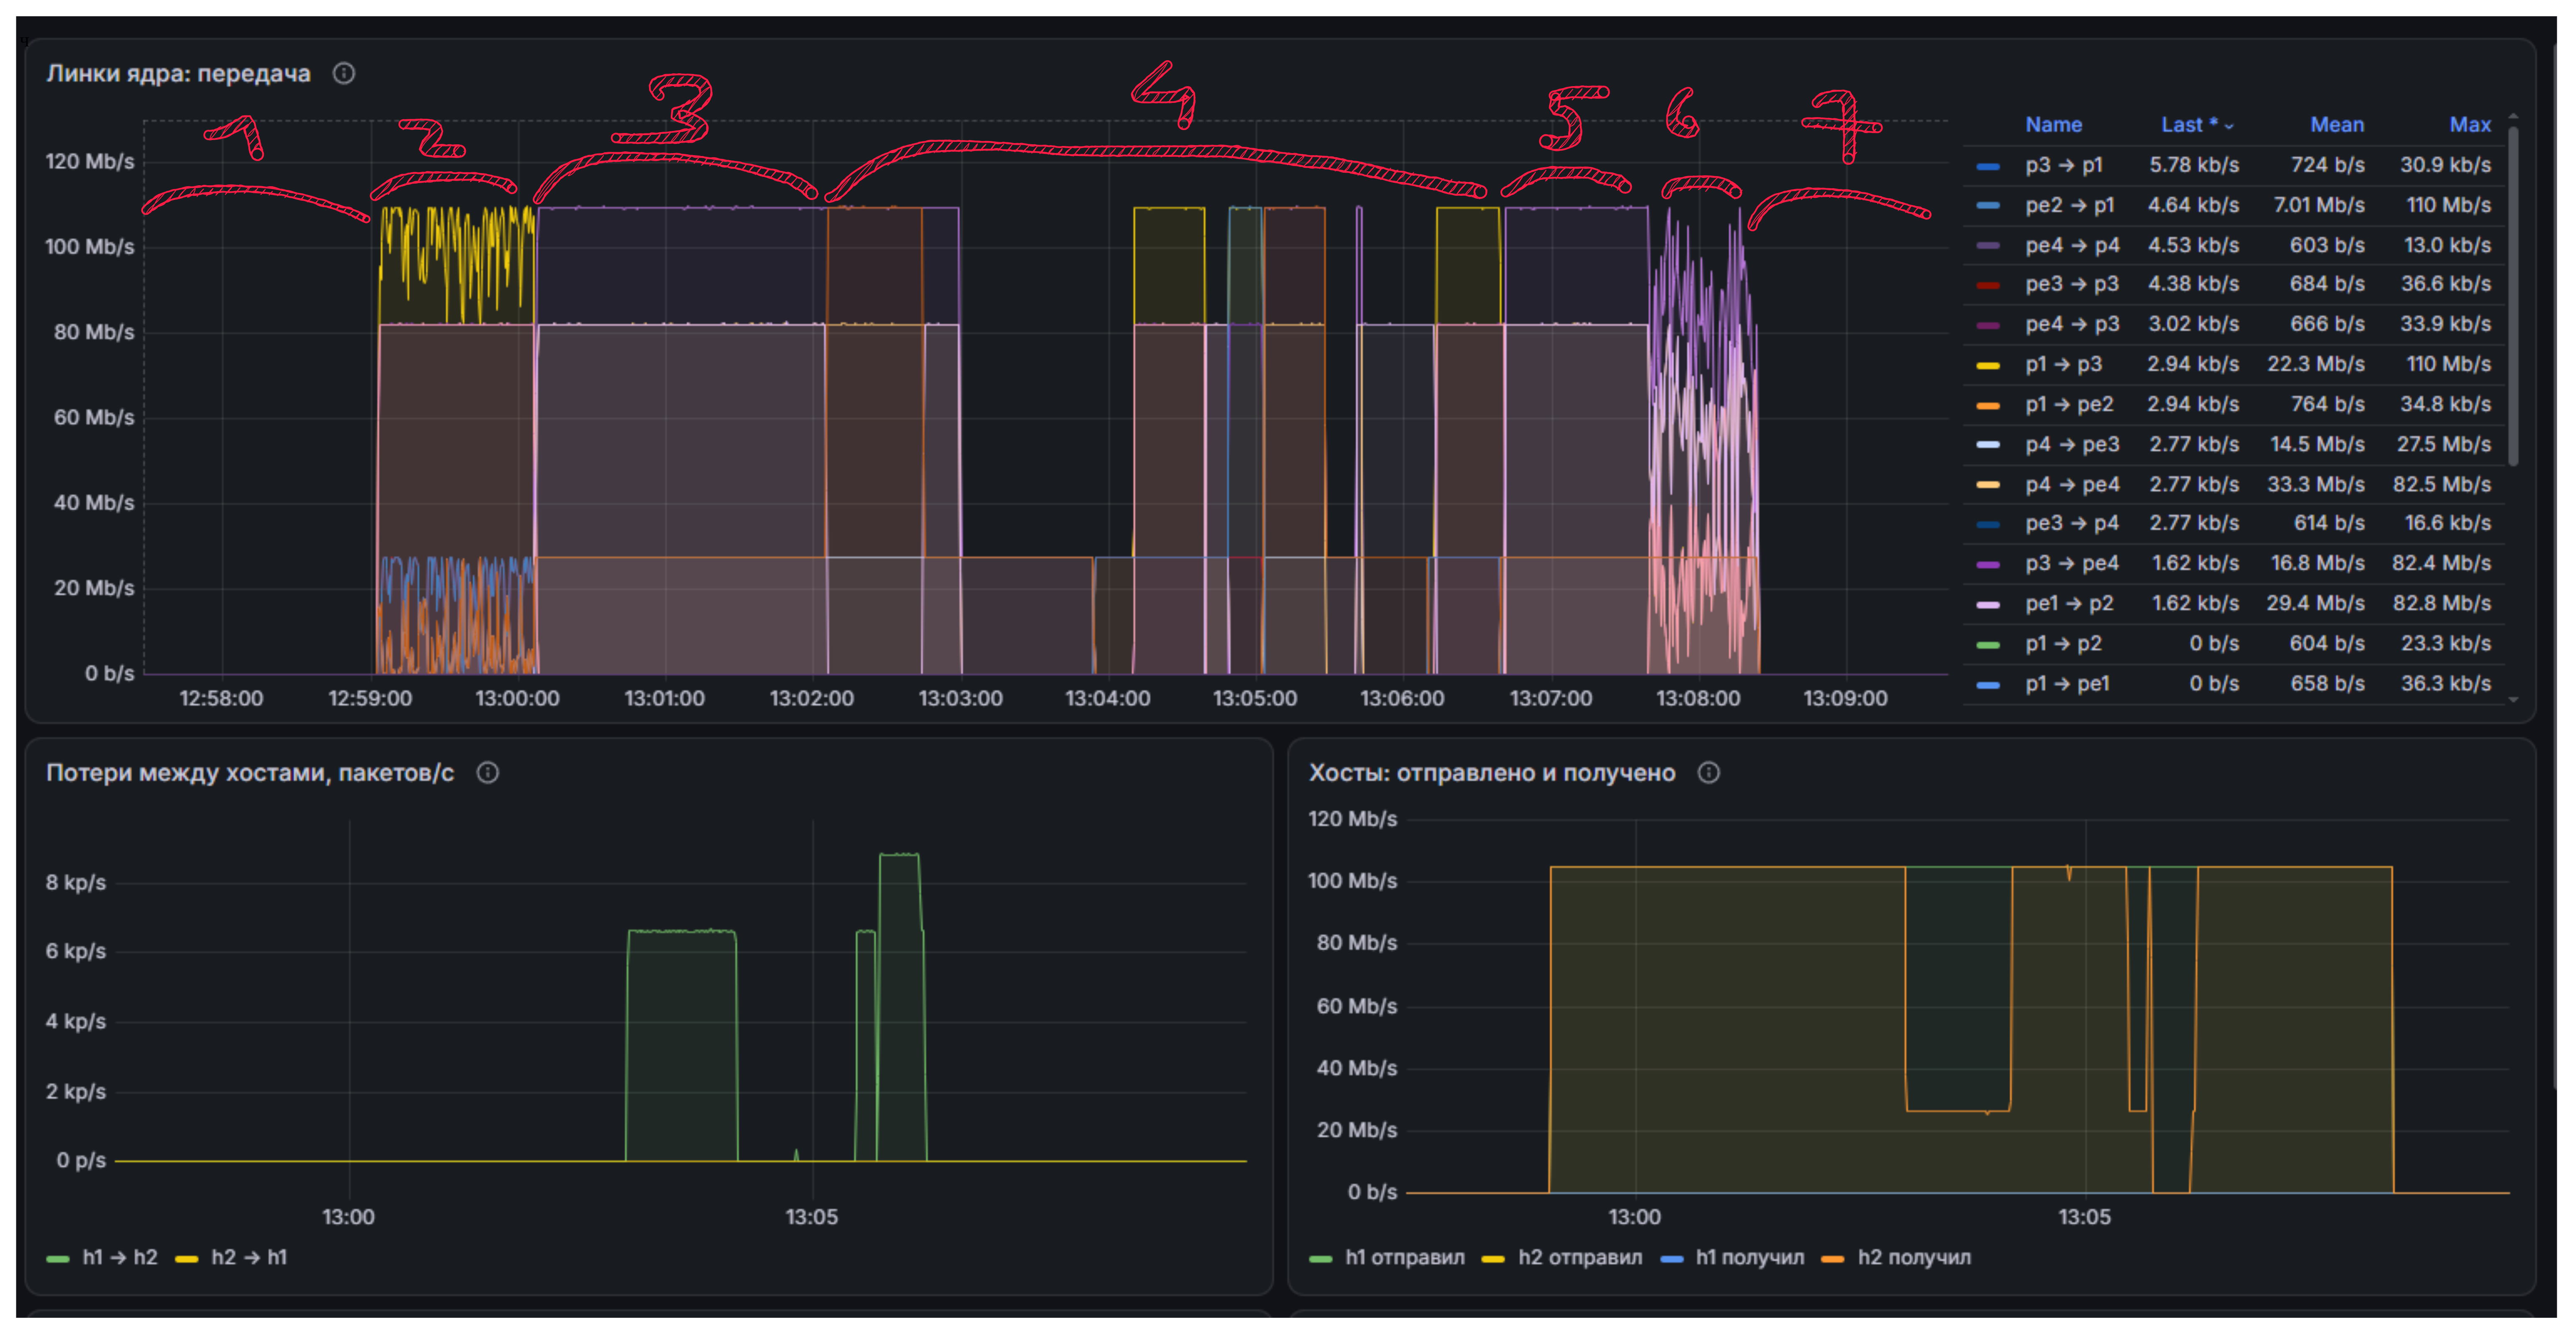
1 - трафика нет
2 - просто запустил iperf, распределяются по ECMP
3 - выбрал нижнее плечо, приоритет ушёл на него
4 - тестирую отказы
5 - тесты завершили и трафик опять вернулось на приоритетное нижнее плечо
6 - убрал приоритет и всё снова балансируется по ECMP
7 - выключил iperf, трафика нет
Теперь надо сравнить пункт 4 (тесты) с тем, что было в консоли.
Эту задачу тоже можно смело доверять нашему рабу, вот такую табличку в итоге составил:
| Сценарий | Потеряно пакетов | Время без трафика | Причина |
|---|---|---|---|
| Аплинк pe1 (eth1 → p1) | 0 | 0 | второй аплинк eth2 → p2 подхватил сразу |
| Даунлинк pe1 (eth3 → CE) | 3 | ~100 мс | CE1 переключился на pe2 по BGP |
| Оба аплинка pe1 | 0 | 0 | CE1 весь трафик ушёл на pe2 |
| Коробка p2 | 468K | ~40 с | IS-IS ждёт hold-time, нет BFD |
| PE целиком, отказ | 366 | ~100 мс | CE1 переключился на pe2 |
| PE целиком, возврат | 84K | ~30 с | локатор pe3 возвращается в таблицу не сразу |
| Зависание p2 (netem) | 255K | ~30 с | то же: IS-IS ждёт hold-time |
В общем, там где интерфейс оставался в up - очевидно были проблемы, BFD нет же, ну и приятно то, что все переключения где явно падали линки прошли практически без потерь.
Включим BFD и проверим ещё раз.
for n in p1 p2 p3 p4 pe1 pe2 pe3 pe4; do sed -i 's/^bfdd=no$/bfdd=yes/' te/$n/daemons;
sed -i 's/^ ipv6 router isis 1$/ ipv6 router isis 1\n isis bfd/' te/$n/frr.conf
пускаем снова на скрипт:
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ bash te/failover.sh
Узлы под тестом: pe1 (аплинки: eth1 eth2, к CE: eth3), p2 (всё: eth1 eth2 eth3 eth4 )
Путь до отказа:
    p4>pe3 82.2 Мбит/с
    p4>pe4 27.4 Мбит/с
    pe4>ce2 26.3 Мбит/с
    ce1>pe1 26.3 Мбит/с
    ce1>pe2 78.8 Мбит/с
    ce2>h2 105.1 Мбит/с
    h1>ce1 105.2 Мбит/с
    p2>p4 109.6 Мбит/с
    pe1>p2 27.4 Мбит/с
    pe2>p2 82.3 Мбит/с
    pe3>ce2 78.8 Мбит/с

=== Отказ аплинка: pe1 теряет линк eth1 в ядро
--- ломаю в 14:07:52.798
    потери на отказе:  без потерь
--- чиню в  14:08:30.462
    потери на возврате: без потерь

=== Отказ даунлинка: pe1 теряет линк eth3 к CE
--- ломаю в 14:08:45.737
    потери на отказе:  без потерь
--- чиню в  14:09:22.190
    потери на возврате: без потерь

=== Отказ обоих аплинков: pe1 остаётся без ядра
--- ломаю в 14:09:37.481
    потери на отказе:  без потерь
--- чиню в  14:10:15.102
    потери на возврате: без потерь

=== Отказ коробки: на p2 гаснут все линки
--- ломаю в 14:10:30.400
    потери на отказе:  151856 пакетов, связи не было 200 мс
--- чиню в  14:11:10.692
    потери на возврате: без потерь

=== Отказ PE целиком: на pe1 гаснут все линки
--- ломаю в 14:11:22.548
    потери на отказе:  77 пакетов, связи не было 100 мс
--- чиню в  14:12:02.326
    потери на возврате: 27852 пакетов, связи не было 100 мс

=== Зависание: линки p2 подняты, но пакеты пропадают
--- ломаю в 14:12:17.686
    потери на отказе:  7821 пакетов, связи не было 200 мс
--- чиню в  14:12:53.543
    потери на возврате: 6921 пакетов, связи не было 100 мс

likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$
ок, прошло, что в графане теперь:
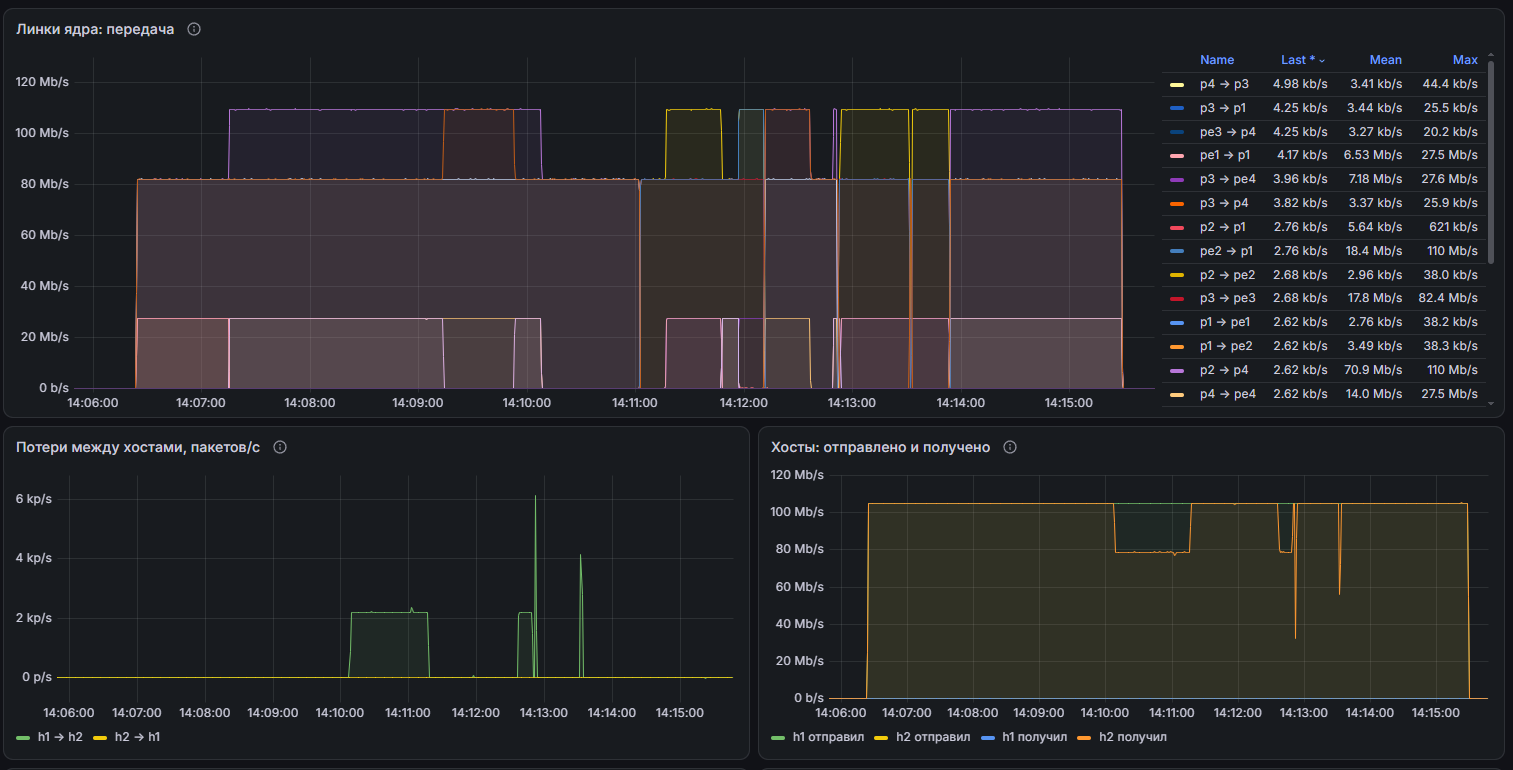
отдадим Клоду поанализировать:
| Сценарий | Было (без BFD) | Стало (с BFD) |
|---|---|---|
| Аплинк pe1 | 0 | 0 |
| Даунлинк pe1 | 3 пак. | 0 |
| Оба аплинка pe1 | 0 | 0 |
| Коробка p2 | 468K пак. | 152K пак. |
| pe1 целиком, отказ | 366 пак. | 77 пак. |
| pe1 целиком, возврат | 84K пак. | 28K пак. |
| Зависание p2 | 255K пак. | 7,8K пак. |
BFD сильно улучшил картину, у меня в среднем iperf выдаёт где-то 8 kpps, т.е. если потерялось 7.6К пакетов, считай не было связи 1 секунду, ну неплохо. Но всё равно есть вот эти пара тестов, где потери сохранились:
- отказ p2, 152к пакетов / 8 kpps = 19 секунд
- отказ pe1, 28к пакетов / 8 kpps = 3,5 секунды
Можно конечно просто списать всё это на чрезмерную виртуальность моей лабы, ну WSL внутри которого containerlab и вот там внутри отказ в несколько секунд…, но я конечно же поковырялся…)
В общем, посидел ещё какое-то время, нашёл в чем была проблема с этими двумя отказами.
С P2, она заключалась в том, что ISIS долго сходился. По дефолту 5 секунд и вот это время соседи ждали, чтобы отдать анонсы. В итоге локаторы не приходили и получается префиксы то по VPNv4 есть, а упаковывать некуда, ну и вот дропы. Вот и всё.
А с PE1, суть была в том, что линки до CE1 поднимались раньше, чем линки в сторону P. PE1 на себя притягивал трафик и успешно его блекхолил. Тут пока что решил оставить текущие 3.5 секунды, кажется не супер критично для моей лабы.
Вариантов было несколько, я выделил вот такие 4:
- включить что-то для контроля состояния uplink и downlink, типа monitor-link в Huawei, но в FRR такого нет, т.к. он не управляет интерфейсами;
- сделать какой-то банальный carrier-delay, просто держать линк в сторону CE неактивным после поднятия, на протяжении 60 секунд к примеру. Аналогично пункту выше - FRR не умеет;
- запилить какой-то кастомный агент, который будет мониторить состояние линков и дальше реагировать. Не захотел, ну просто не вижу смысла, можно сделать и будет работать, но не хочу;
- и последний вариант, который ещё я подумал, это поправить таймеры в isis. Там стоит дефолт в 5 секунд, так вот просто выставить чуть агрессивней схождение внутри ядра, тогда и маршруты от других PE быстрее дойдут. Ну и это легко и просто, поэтому его и сделал.
Вот так:
lsp-timers gen-interval 1 refresh-interval 900 max-lifetime 1200
Если бы мы говорили про прод, то я бы выбрал вариант 3. Сделал бы отдельного агента и не менял дефолтные таймеры, а ещё лучше если бы это была полноценная коробка и тогда вообще включить monitor-link, самый понятный и адекватный вариант.
Так, ну вот тут снизили в общем таймеры и уже эта история будет сильно быстрее, как минимум на сходимость с p2 точно мы повлияем.
Повторяем тест и смотрим, что там:
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ bash te/failover.sh

=== Отказ аплинка: pe1 теряет линк eth1 в ядро
--- ломаю в 00:46:30.327
    потери на отказе:  без потерь
--- чиню в  00:47:09.727
    потери на возврате: без потерь

=== Отказ даунлинка: pe1 теряет линк eth3 к CE
--- ломаю в 00:47:25.006
    потери на отказе:  4 пакетов, связи не было 100 мс
--- чиню в  00:48:03.536
    потери на возврате: без потерь

=== Отказ обоих аплинков: pe1 остаётся без ядра
--- ломаю в 00:48:18.807
    потери на отказе:  без потерь
--- чиню в  00:48:58.282
    потери на возврате: 281497 пакетов, связи не было 100 мс

=== Отказ коробки: на p2 гаснут все линки
--- ломаю в 00:49:13.608
    потери на отказе:  235 пакетов, связи не было 100 мс
--- чиню в  00:49:52.139
    потери на возврате: 5265 пакетов, связи не было 100 мс

=== Отказ PE целиком: на pe1 гаснут все линки
--- ломаю в 00:50:07.533
    потери на отказе:  312 пакетов, связи не было 100 мс
--- чиню в  00:50:46.231
    потери на возврате: 25158 пакетов, связи не было 100 мс

=== Зависание: линки p2 подняты, но пакеты пропадают
--- ломаю в 00:51:01.580
    потери на отказе:  14953 пакетов, связи не было 100 мс
--- чиню в  00:51:40.997
    потери на возврате: 6780 пакетов, связи не было 100 мс

likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$
Ну и наша графана:
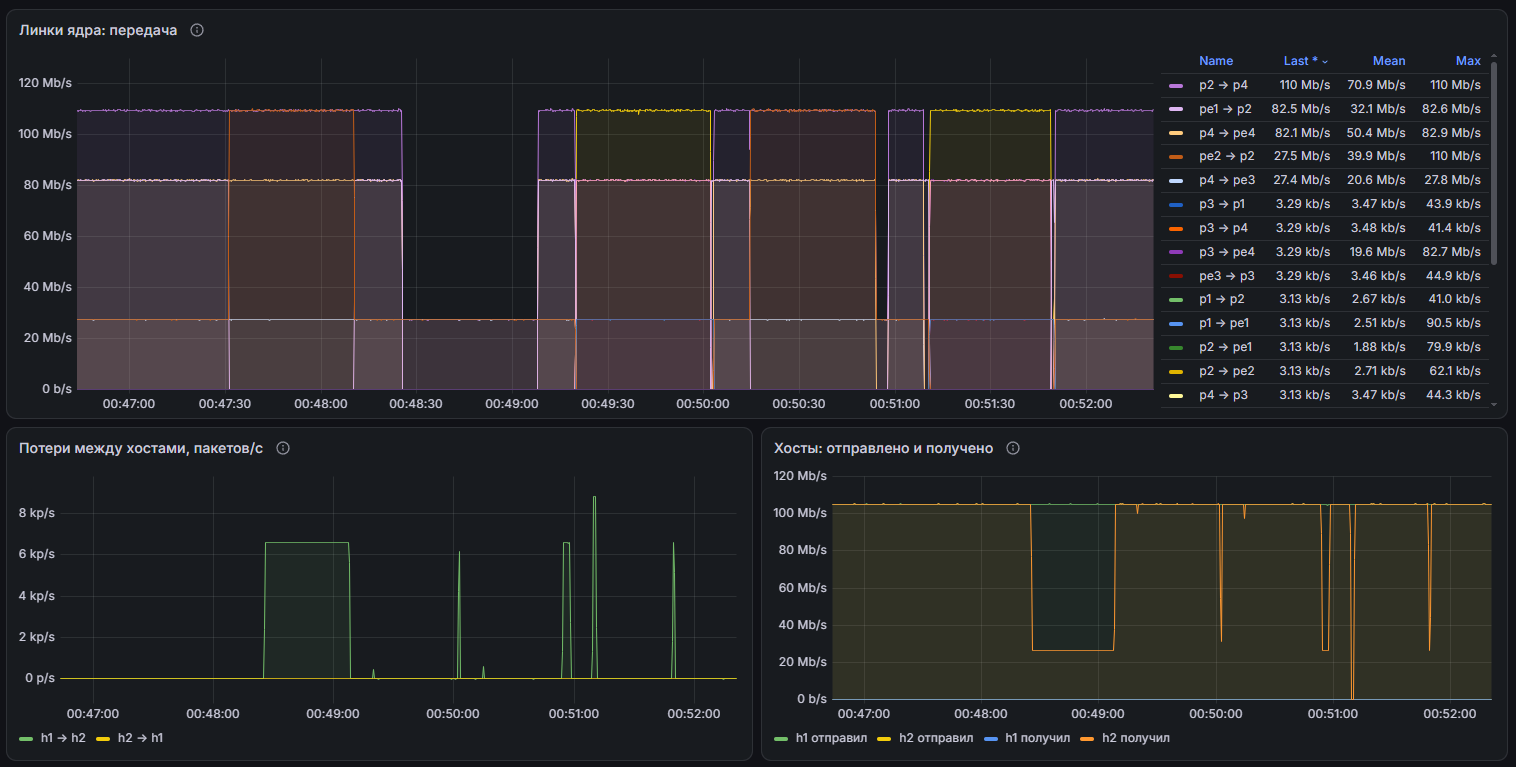
Да ёбаный-корёбаный. Сколько можно… Снова у нас потери измеряются в сотнях тысяч…
Пошёл снова изучать, причем, вот вы думаете хули там ковырять. Кинул в клода и пошёл пить пиво, так вот хер там. Он не вдупляет что происходит. Ну точнее, он может что-то сравнивать, что-то там анализировать, но за ним глаз да глаз. Там буквально через пару хопов начинается уже предложения по разработке своей NOS или чего-то похожего.
Короче, в целом проблема грубо говоря ясна, где-то на PE1 блекхолится снова трафик. Ну и т.к. прикол с ISIS мы уже починили, то наверняка же остался такой же, только с BGP.
Смотрим че там вообще:
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ sudo docker exec clab-srv6-lab2-pe1 vtysh -c "show bgp vrf RED ipv4 unicast 10.2.0.0/24"
BGP routing table entry for 10.2.0.0/24, version 8
Paths: (4 available, best #1, vrf RED)
  Advertised to peers:
  192.168.11.1
  Imported from 13:100:10.2.0.0/24
  65002
    10.255.0.13 from 0.0.0.0 (10.255.0.11) vrf default(0) announce-nh-self
      Origin incomplete, metric 0, localpref 100, valid, sourced, local, multipath, best (Neighbor IP)
      Extended Community: RT:65000:100
      Originator: 10.255.0.13, Cluster list: 10.255.0.1
      Remote labels: 16
      Remote SID: fc00:13::, sid structure=[40 24 16 0 16 64]
Это маршрут от RR в момент отказа, то есть он должен его признать то invalid. Ему то надо упаковать в Remote SID, а его нет вообще:
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ sudo docker exec clab-srv6-lab2-pe1 ip -6 route show fc00:13::/64
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$
Ну и тут вот косяк происходит, он видимо считает, что маршрут валидный, т.к. сессия до RR живая - hold timer дефолтный в 180 секунд. Плюс проверки на next-hop никакой нет. По идее было бы неплохо, если бы он проверил возможность дотянуться до Remote SID, но увы… FRR не умеет.
Я для себя так это описал:
- маршрут валидный
- анонс уходит в CE1
- трафик приходит на PE1
- PE1 не знает во что его упаковывать и дропает
Короче, решение - натянуть BFD до RR.
Делаем.
router bgp 65000
 neighbor RR bfd
и проверяем
sudo docker exec clab-srv6-lab2-pe1 vtysh -c "show bfd peers brief"

Session count: 4
SessionId  LocalAddress    PeerAddress     Status
=========  ============    ===========    ======
4137436323 fc00::11        fc00::1        up
1758617092 fc00::11        fc00::3        up
4094756354 fe80::a8c1:...  fe80::a8c1:... up
629036176  fe80::a8c1:...  fe80::a8c1:... up
есть +2 сессии, кажется мы готовы…
Ладно, ДАВАЙТЕ В ПОСЛЕДНИЙ РАЗ, меня зовут Питер Паркер… (с)
Прогоняем ещё раз все наши тесты.
Остановил трафик, запустил снова, переключил на нижнее плечо, пробую отказ.
likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$ bash te/failover.sh

=== Отказ аплинка: pe1 теряет линк eth1 в ядро
--- ломаю в 02:13:11.012
    потери на отказе:  без потерь
--- чиню в  02:13:49.792
    потери на возврате: без потерь

=== Отказ даунлинка: pe1 теряет линк eth3 к CE
--- ломаю в 02:14:04.996
    потери на отказе:  2 пакетов, связи не было 100 мс
--- чиню в  02:14:44.396
    потери на возврате: без потерь

=== Отказ обоих аплинков: pe1 остаётся без ядра
--- ломаю в 02:14:58.881
    потери на отказе:  3584 пакетов, связи не было 100 мс
--- чиню в  02:15:38.285
    потери на возврате: без потерь

=== Отказ коробки: на p2 гаснут все линки
--- ломаю в 02:15:52.638
    потери на отказе:  262 пакетов, связи не было 200 мс
--- чиню в  02:16:32.184
    потери на возврате: 4084 пакетов, связи не было 100 мс

=== Отказ PE целиком: на pe1 гаснут все линки
--- ломаю в 02:16:47.546
    потери на отказе:  170 пакетов, связи не было 100 мс
--- чиню в  02:17:26.174
    потери на возврате: 26258 пакетов, связи не было 100 мс

=== Зависание: линки p2 подняты, но пакеты пропадают
--- ломаю в 02:17:41.547
    потери на отказе:  6529 пакетов, связи не было 200 мс
--- чиню в  02:18:20.984
    потери на возврате: 4524 пакетов, связи не было 100 мс

likeabus@DESKTOP-BEF0PVR:~/srv6-frr-lab$
вот графана:
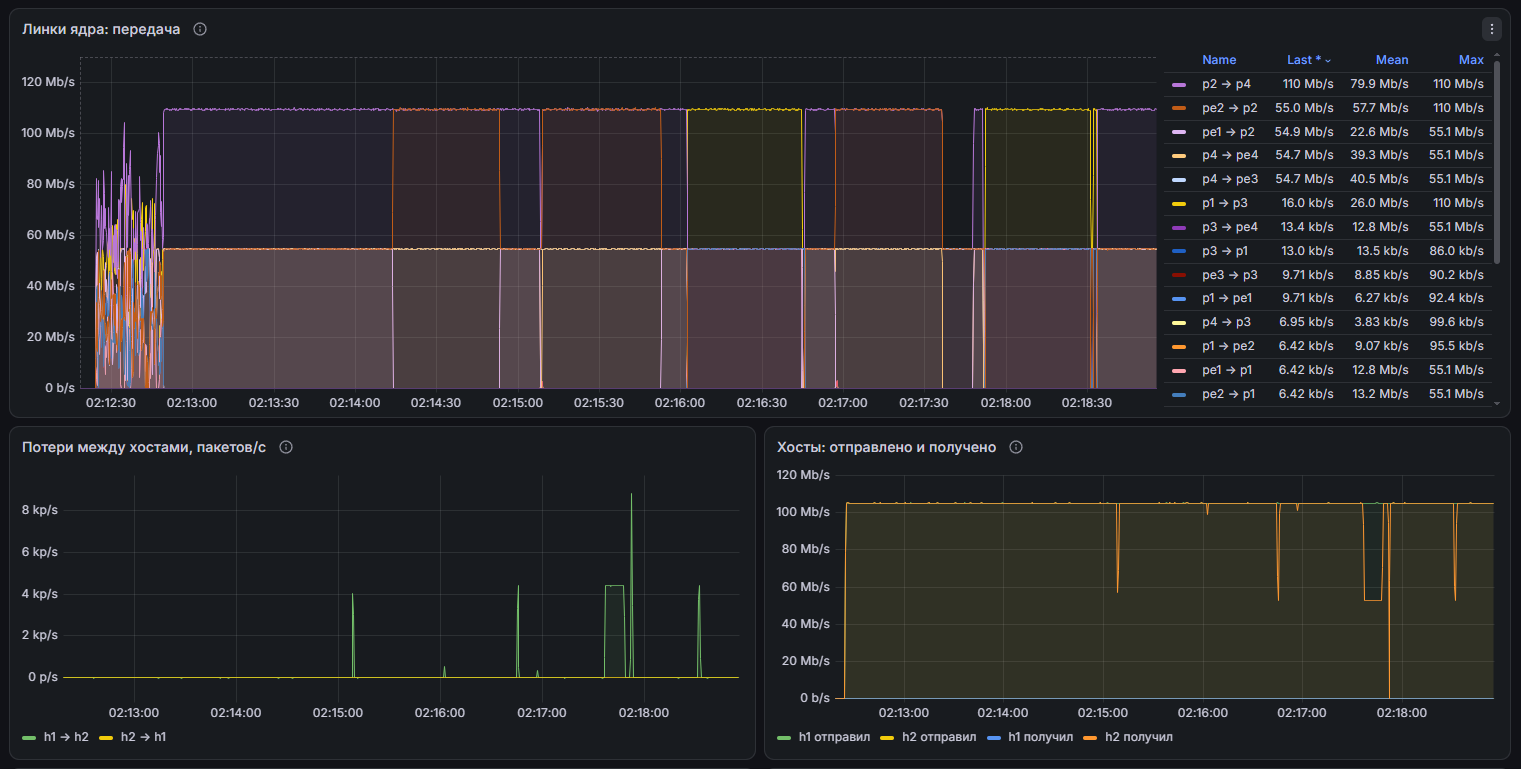
Сводная таблица всех тестов:
| Сценарий | Без BFD | + BFD | + gen-interval | + BFD к RR |
|---|---|---|---|---|
| Аплинк pe1 | 0 | 0 | 0 | 0 |
| Даунлинк pe1 | 3 | 0 | 4 | 2 |
| Оба аплинка pe1 | 0 | 0 | 281K | 3584 |
| Коробка p2 | 468K | 152K | 235 | 262 |
| pe1 целиком, отказ | 366 | 77 | 312 | 170 |
| pe1 целиком, возврат | 84K | 28K | 25K | 26K |
| Зависание p2 | 255K | 7,8K | 15K | 6529 |
Найс.
Потери практически ушли и остались совсем незначительные. Самые заметные - это всё то
же восстановление PE1, когда линк в CE1 поднимается быстрее, чем собирается всё в ядре.
По-хорошему надо идти и делать того самого агента, нууу, может быть… когда-нибудь)
Что в итоге?
- докинули мониторинг
- добавили ноды с iperf
- превратили контроллер в БУДКУ
- включили балансировку по flow label
- прогнали тесты, помучали немного коробки
- добавили BFD и чуть поправили таймеры в ISIS
ну в общем вот, нормальные выходные)
лаба всё там же, можно смело ковырять https://github.com/like-a-bus/srv6-frr-lab.
Следить за новыми статьями — в канале.